import torch
import torch.nn as nn

class SimpleConvLayer(nn.Module):
    def __init__(self):
        super(SimpleConvLayer, self).__init__()
        self.conv = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, stride=1, padding=1)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.conv(x)  # Convolution
        x = self.relu(x)  # Fonction d'activation
return xCNN
Augustin Chevallier
1 Introduction
1.1 Pourquoi les CNN ?
- MLP pour données tabulaires :
- Modèles adaptés aux données sans structure particulière (tableaux)
- Pas d’a priori sur les interactions entre caractéristiques
- Défis des données perceptuelles haute-dimension :
- Images haute résolution = très grand nombre de paramètres
- Couches entièrement connectées = coûteuses en ressources et en données
- Les images ont une structure :
- Présence de motifs spatiaux exploitables
- Rend l’apprentissage plus efficace
- Solution : CNN :
- Exploitent la structure spatiale, par exemple des images
- Réduisent les paramètres nécessaires grâce aux motifs locaux et aux poids partagés
1.2 Historique des CNN
- Années 1980 :
- Inspiration biologique par le cortex visuel (Travaux de Hubel et Wiesel)
- Réseaux de Neocognitron : premiers CNN pour reconnaissance de motifs (Fukushima)
- Années 1990 :
- LeNet-5 par Yann LeCun : utilisé pour la reconnaissance de chiffres écrits à la main
- Exploite la convolution et le pooling pour réduire le nombre de paramètres
- 2012 :
- AlexNet : modèle de Krizhevsky et Hinton qui gagne le concours ImageNet
- Réseau profond (8 couches) qui popularise les CNN et le deep learning
- Depuis 2012 :
- Explosion des architectures CNN : VGG, ResNet, Inception…
- Applications au-delà des images : vision par ordinateur, NLP, bio-informatique
1.3 AlexNet
- AlexNet : Article révolutionnaire publié en 2012 par Alex Krizhevsky, Ilya Sutskever, et Geoffrey Hinton.
- Utilisation de Convolutional Neural Networks (CNNs) pour la vision par ordinateur.
Impact de l’Article
- Performance exceptionnelle : AlexNet a remporté la compétition ImageNet en 2012 avec un taux d’erreur bien inférieur à celui des autres modèles.
- Profondeur des réseaux : AlexNet a montré l’efficacité de l’apprentissage profond (Deep Learning) pour des tâches complexes.
- Les CNN prennent le pas sur les autres techniques de classifications d’images.
1.4 Idée
- On construit des filtres
- Un filtre identifie une structure locale dans l’image
- par exemple un bord vertical
- On applique le filtre à toute l’image
- L’apprentissage apprend les meilleurs filtres
Avantages:
- Un filtre a un faible nombre de paramètres comparé à une couche entièrement connectée
- Invariant par translation!
- On peut interpréter les résultats - on peut afficher les filtres - ainsi que leurs effets sur les images
1.5 Idée 2
- On réduit progressivement la dimension de l’image
- Les filtres sont de moins en moins locaux
- Les filtres apprennent des caractéristiques de plus en plus haut niveau

2 Convolutional Layer
2.1 Filter
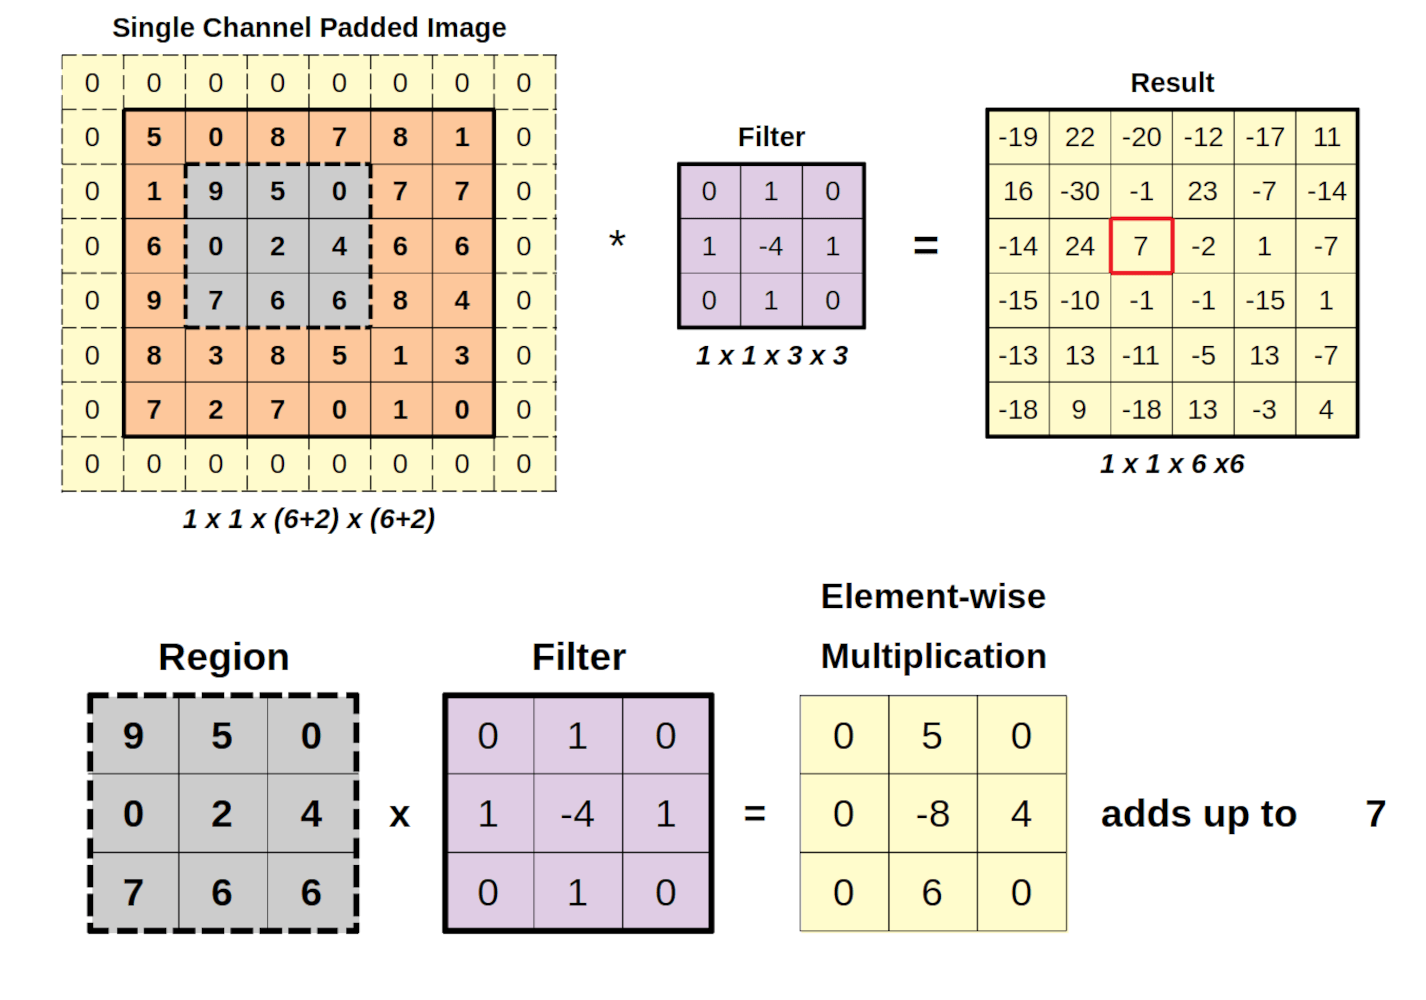
- Soit une entrée \(X\) et un noyau \(K\).
- La valeur en position \((i, j)\) de la sortie \(Y\) est : \[ Y(i, j) = \sum_m \sum_n X(i + m, j + n) \cdot K(m, n) \]
- Glissement du noyau : on fait glisser \(K\) sur \(X\) et on effectue une somme pondérée.
2.2 Feature Map
Dans un CNN, la sortie d’un filtre est appelée Feature Map
Exemple: Prewitt operator
- But: détection des bords verticaux

2.3 Padding
- Problème : Lors des convolutions, la taille de l’image de sortie est réduite.
- Solution : Ajouter du padding (bordures de pixels) autour de l’image pour :
- Préserver les dimensions d’origine de l’image de sortie.
- Conserver l’information aux bords.
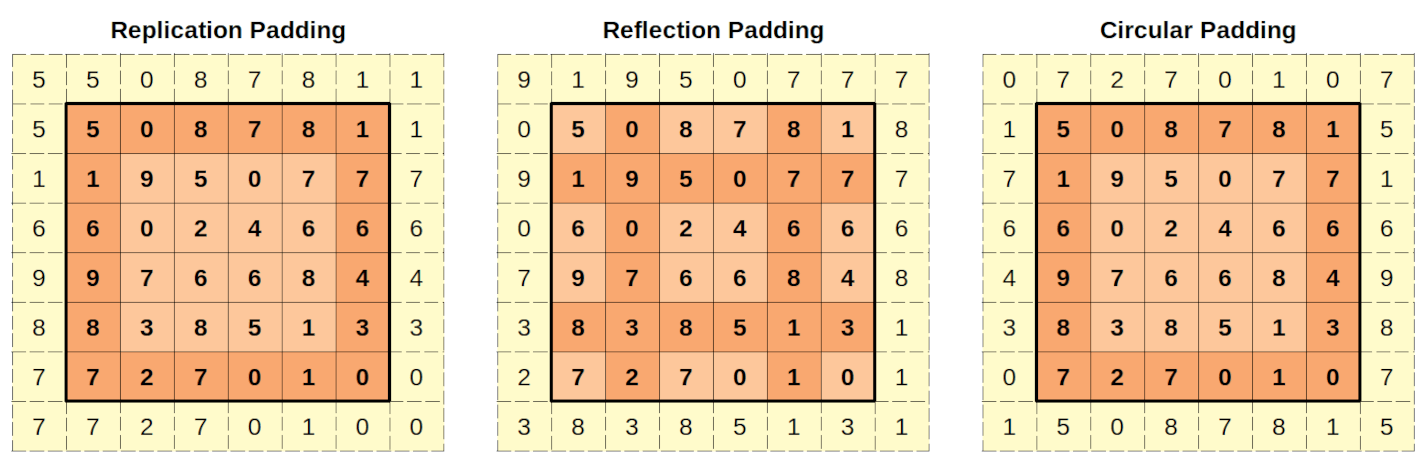
Types de Padding
- Zero Padding : Ajouter des pixels de valeur zéro autour de l’image.
- Replicated Padding : Répliquer les pixels aux bords.
- Reflective Padding : Utiliser une réflexion des pixels autour des bords.
2.4 Stride
- Stride : nombre de pixels de déplacement du noyau (filtre) à chaque étape.
- Stride par défaut = 1 (le filtre se déplace d’un pixel à la fois).
- Effet : Contrôle la réduction de taille de la sortie, plus le stride est grand, plus la sortie est petite.
2.5 Dilatation
Dilatation : Espacement des éléments dans le noyau en ajoutant des “trous” (valeurs de remplissage).
Permet au noyau de couvrir une plus grande zone sans augmenter sa taille.
Effet : Capture des motifs sur une échelle plus large tout en réduisant les informations perdues par sous-échantillonnage.
Dilatation de facteur \(d\) signifie qu’on laisse \(d - 1\) pixels vides entre les éléments du noyau.
Exemple : Un noyau \(3 \times 3\) avec une dilatation de \(d=2\) couvre un espace de \(5 \times 5\) pixels.
2.6 Dimensions de sortie
Taille de l’entrée \(n \times n\)
Taille du noyau \(k \times k\)
Padding \(p\)
Stride \(s\)
Dilatation \(d\)
La dimension de sortie, notée \(n_{\text{out}}\), est calculée par : \[ n_{\text{out}} = \frac{n + 2p - d \cdot (k - 1) - 1}{s} + 1 \]
2.7 Channels
- Un channel (canal) représente une dimension de profondeur dans une image ou une feature map.
- Exemple : Les images RGB ont 3 channels (Rouge, Vert, Bleu).
2.8 Plusieurs Channels
Entrée avec Plusieurs Channels
- L’entrée peut avoir plusieurs channels (ex. image RGB avec 3 channels).
- Soit une entrée de taille \((H \times W \times C_{in})\), où :
- \(H\) : Hauteur
- \(W\) : Largeur
- \(C_{in}\) : Nombre de channels d’entrée
Application de la Convolution
- Filtre : Chaque filtre est appliqué à tous les channels d’entrée.
- Si on a \(C_{in}\) channels, le filtre sera de taille \((k \times k \times C_{in})\), où \(k\) est la taille du noyau.
- Chaque filtre produit un seul channel en sortie, en combinant les informations des \(C_{in}\) channels d’entrée.
2.9 Sortie avec Plusieurs Channels
- Une couche convolutionnelle peut avoir plusieurs filtres
- La sortie de la couche convolutionnelle a \(C_{out}\) channels, où chaque filtre génère un channel en sortie.
- La taille de la sortie est donc \((H_{\text{out}} \times W_{\text{out}} \times C_{out})\).
2.10 Convolutional layer
- matrice des poids: contient les matrices des filtres
- vecteur des biais: contient un biais par filtre
3 CNN
3.1 Pooling
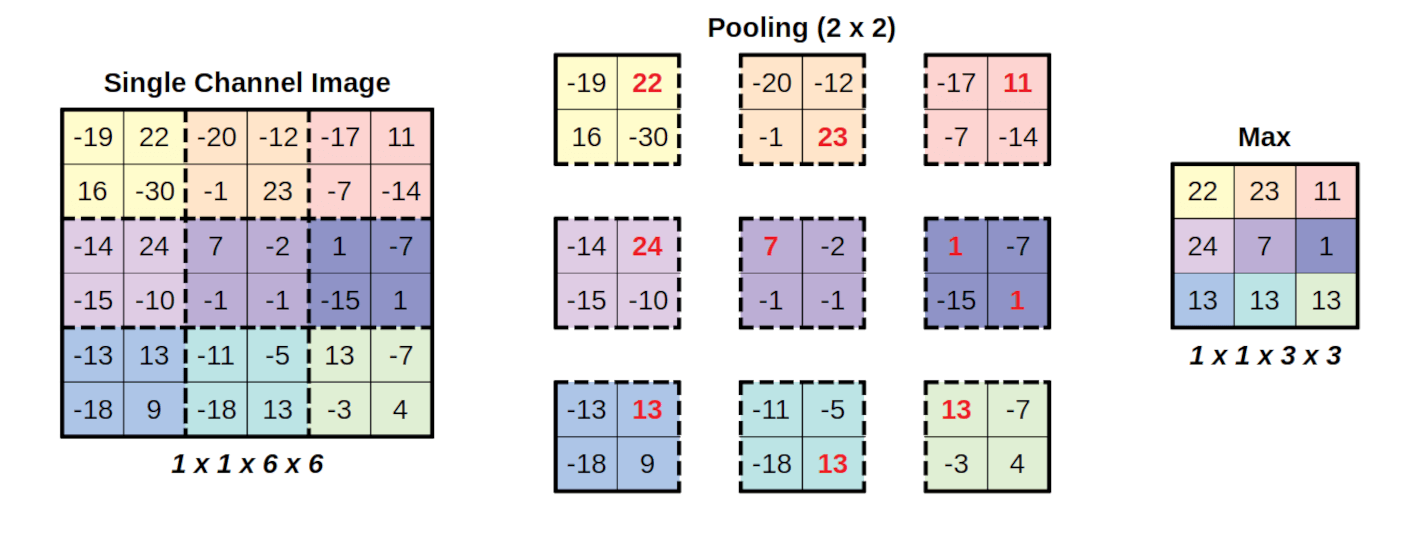
- Pooling : Réduit la taille des feature maps tout en conservant les informations importantes.
- But : Diminuer la complexité computationnelle et contrôler le surapprentissage.
- Types courants :
- Max Pooling : Sélectionne la valeur maximale dans chaque fenêtre.
- Average Pooling : Calcule la moyenne des valeurs dans chaque fenêtre.
Pooling avec un stride de 2 et une taille de fenêtre de 2 :
3.2 Exemple pytorch
CNN pour des images 28x28:
import torch.nn as nn


class SimpleCNN(nn.Module):
    def __init__(self):
        super(SimpleCNN, self).__init__()
        # Première couche de convolution (entrée : 1 canal, sortie : 32 filtres)
        self.conv1 = nn.Conv2d(1, 32, kernel_size=3, padding=1)
        # Deuxième couche de convolution (entrée : 32 canaux, sortie : 64 filtres)
        self.conv2 = nn.Conv2d(32, 64, kernel_size=3, padding=1)
        # Couche de pooling
        self.pool = nn.MaxPool2d(2, 2)
        # Couche entièrement connectée
        self.fc1 = nn.Linear(64 * 7 * 7, 10)  # Image de 28x28, réduite à 7x7 après 2 poolings

    def forward(self, x):
        # Première convolution + ReLU + Pooling
        x = self.pool(F.relu(self.conv1(x)))
        # Deuxième convolution + ReLU + Pooling
        x = self.pool(F.relu(self.conv2(x)))
        # Aplatir pour la couche entièrement connectée
        x = x.view(-1, 64 * 7 * 7)
        # Couche entièrement connectée
        x = self.fc1(x)
        return x
3.3 Receptive Field
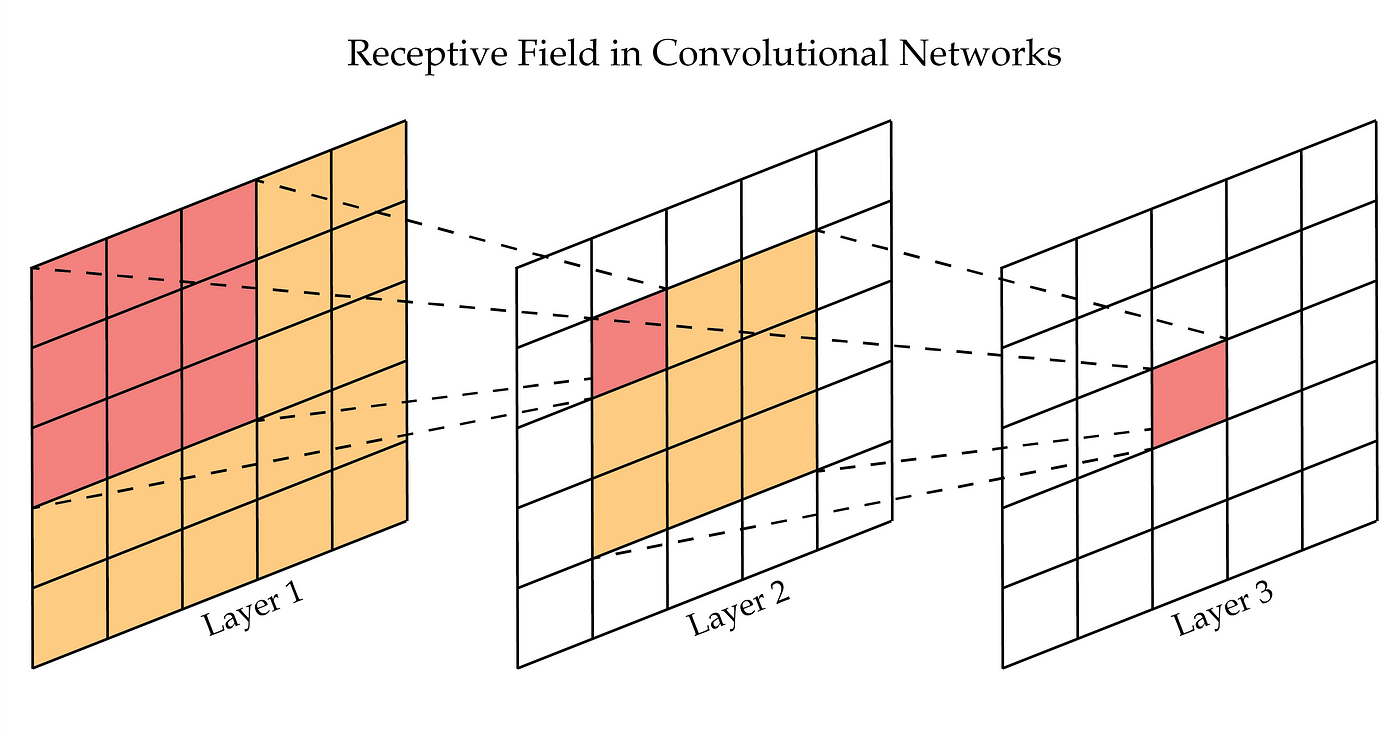
- Définition :
- Zone dans l’entrée influençant une caractéristique spécifique dans le CNN.
- Indique la région de la donnée d’origine qui contribue à une activation particulière en sortie.
- Illustration :
- Dans un CNN avec plusieurs couches (ex : filtre (3 ) par couche), le champ réceptif d’un pixel en couche profonde couvre une plus grande zone de l’image d’origine.
3.4 Receptive Field 2
- Importance en vision par ordinateur :
- Segmentation d’image : un champ réceptif large permet de capturer les contours complets des objets.
- Détection d’objets : essentiel pour détecter des objets de grande taille dans l’image.
- Importance :
- Permet une hiérarchie des informations : les premières couches captent les détails, les dernières couches captent la structure globale.
3.5 Pour aller plus loin
https://d2l.ai/chapter_convolutional-modern/index.html
4 Calcul GPU
4.1 Device
Le code est exécuté sur un device
- par défaut: CPU
- s’il est disponible, on peut utiliser le GPU avec CUDA pour les cartes graphiques NVIDIA
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"Utilisation du device : {device}")
Utilisation du device : cudaLe résultat dépend de l’environnement d’exécution : cuda si un GPU est disponible, cpu sinon.
4.2 Utilisation
Chaque device dispose de sa propre mémoire
- par défaut un tensor est créé sur le device CPU
- il faut déplacer les tensors vers le device sur lequel on souhaite effectuer les calculs
- on peut afficher le device sur lequel un tensor est
- on peut aussi envoyer un modèle complet (et ses paramètres) avec model.to(device)
- les calculs sont effectués sur le device du tensor
- on ne peut pas mélanger dans les calculs des tensors sur des devices différents