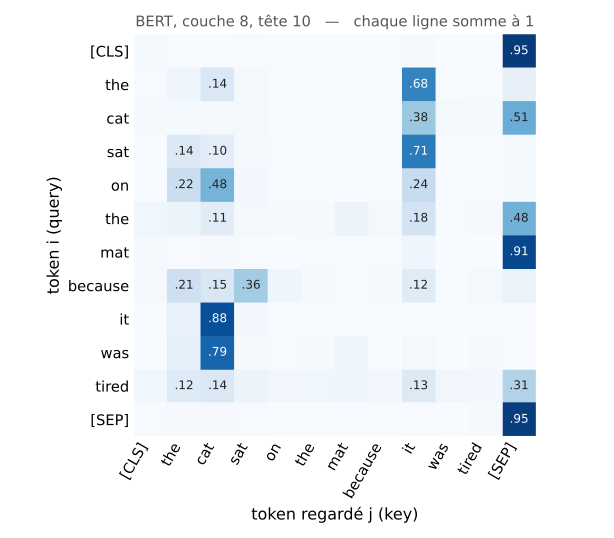
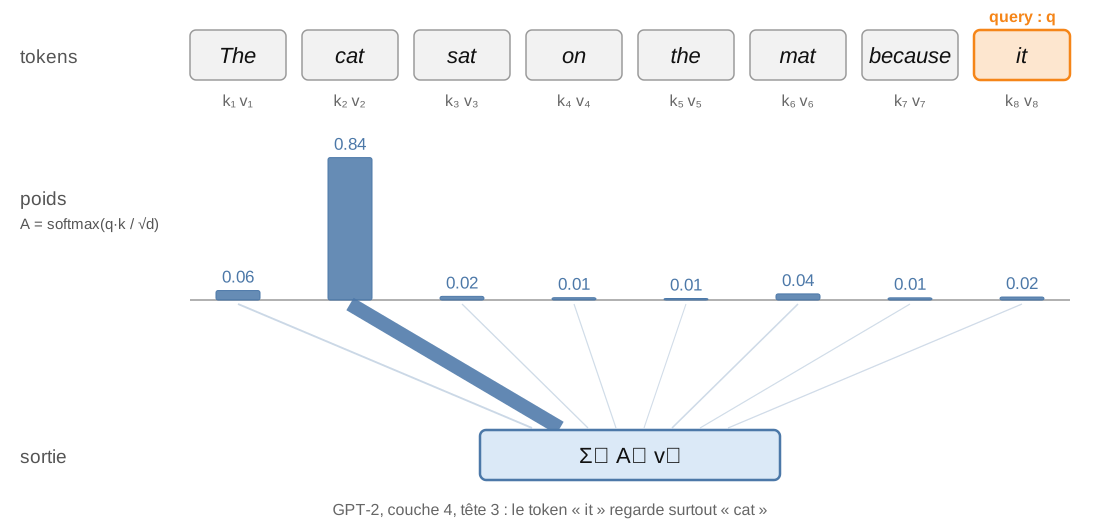
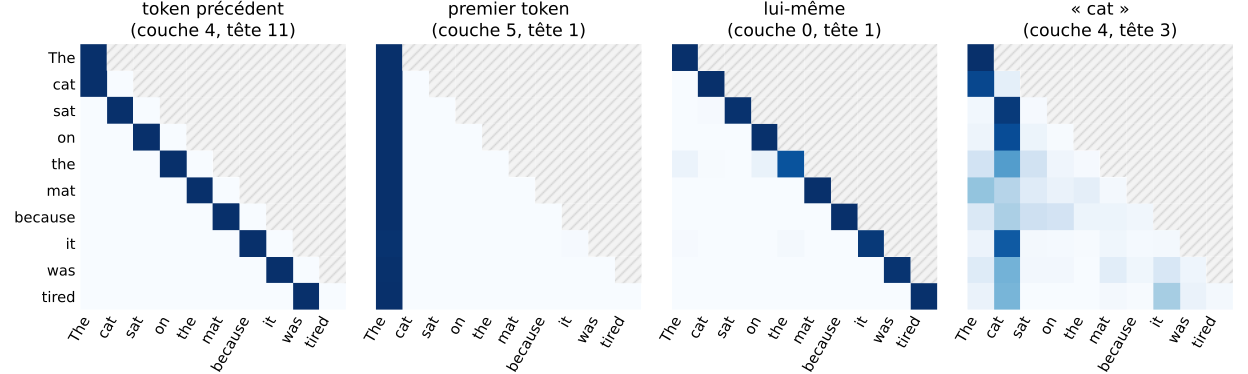
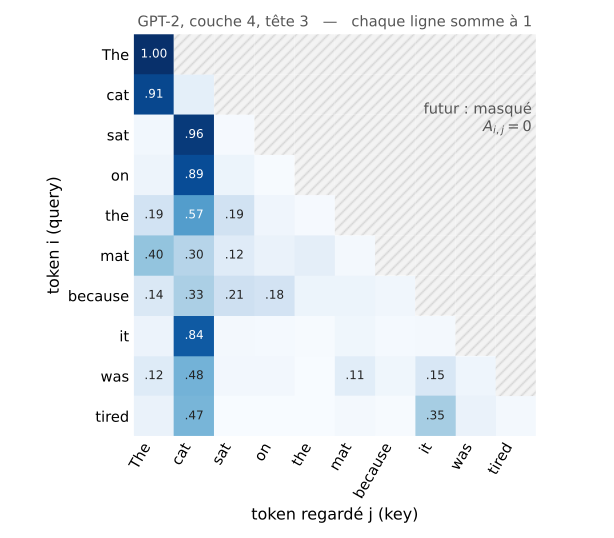
permet de porter attention à des choses différentes
un mécanisme d’attention = une tête (head)
nombre de têtes (heads) noté \(h\)
Têtes réelles de GPT-2 : chaque tête apprend un motif différent
1.10 MultiHead 2
Principe :
Projeter l’entrée dans \(h\) sous-espaces de dimension \(d_{model}/h\).
Autrement dit: \(d_k = d_{model}/h\)
Calculer \(h\) attentions indépendantes
Concaténer les résultats
Appliquer une couche linéaire finale \(W^O\) matrice \(d_{model}\times d_{model}\)
Formule : \[ \text{MultiHead}(Q,K,V)=\text{Concat}(\text{head}_1,\dots,\text{head}_h)W^O \]
1.11 Remarque: pourquoi \(W^O\) ?
On note \(\text{head}_i = A_i X W_V^i\) la sortie de la tête \(i\), et \(W_O^i\) (\(d_v \times d_{model}\)) le \(i\)-ème bloc de lignes de \(W^O\) :
\[ \text{Concat}(\text{head}_1,\dots,\text{head}_h)W^O = \sum_{i=1}^{h} A_i X \, (W_V^i W_O^i) \]
\(W_V^i W_O^i\) est une matrice \(d_{model} \times d_{model}\) de rang \(\le d_v\)
on pourrait l’absorber en une seule matrice de valeurs par tête
on ne le fait pas, pour les mêmes raisons que \(W_Q W_K^\top\) : on paramétrise une matrice de rang faible, avec moins de paramètres (\(2\, d_{model} d_v\) au lieu de \(d_{model}^2\) par tête), et l’attention est calculée en dimension \(d_v\)
Sans \(W^O\) (\(W^O = I\)) :
la tête \(i\) ne peut écrire que dans son bloc de coordonnées
avec \(W^O\), chaque tête peut écrire dans n’importe quel sous-espace de \(\mathbb{R}^{d_{model}}\)
2 Transformer
2.1 Le bloc transformer 1
Entrée:
une séquence de tokens de taille \(T\) (un token = un vecteur)
\(X \in \mathbb{R}^{T \times d_{\text{model}}}\)
Sortie:
une séquence de tokens de taille \(T\)
\(Y \in \mathbb{R}^{T \times d_{\text{model}}}\)
2.2 Le bloc transformer 2
Bloc transformer (version simplifiée, sans normalisation):
Attention : mélange l’information entre les tokens\[ X_1 = X + \text{MultiHeadAttention}(X) \qquad X_1 \in \mathbb{R}^{T \times d_{model}} \]
FeedForward : appliqué à chaque token séparément, avec les mêmes poids pour tous les tokens \[ Y[t,:] = X_1[t,:] + FF(X_1[t,:]) \qquad t = 1, \dots, T \] On note simplement \(Y = X_1 + FF(X_1)\), avec \(FF\) appliqué ligne par ligne.
\(FF\) : MLP à 1 couche cachée de taille \(d_{ff}\), typiquement \(d_{ff} = 4\, d_{model}\)
2.3 Le chemin résiduel
Chaque sous-couche lit le chemin résiduel et ajoute sa contribution (\(\oplus\))
Si on retire les sous-couches, la sortie vaut \(X\) : le chemin résiduel transmet directement l’entrée à la sortie
2.4 Résidus : rappel
Voir le cours “Architectures profondes”, section “Connexions résiduelles”.
Pourquoi les résidus ?
Permettent de transmettre directement le signal de l’entrée jusqu’à la sortie
Facilitent l’apprentissage des réseaux profonds (jusqu’à 12–24 couches ou plus)
Empêchent que la transformation du bloc écrase complètement l’information originale
2.5 Normalisation
On ajoute des LayerNorm (voir cours “Architectures profondes”) pour contrôler la variance du signal
Dans un transformer, la LayerNorm s’applique à chaque token séparément : on normalise sur ses \(d_{model}\) features
Barres : variance de \(x_l\) selon l’origine (si \(\text{Var}(x_0) = \text{Var}(F_l) = 1\), indépendants)
La LN ramène la variance à 1 : tout ce qui précède est divisé, les premières couches sont écrasées
Le gradient le long du chemin résiduel est divisé à chaque LN (pas celui qui passe par les \(F_l\))
2.9 Pre-LN : le problème
Chaque \(F_l\) ajoute une contribution de même taille (son entrée est normalisée) : la part de la dernière couche diminue, les couches de la fin comptent de moins en moins
Bilan : Post-LN écrase les couches du début, Pre-LN celles de la fin. En pratique, Pre-LN (souvent avec RMSNorm) est le choix par défaut.
2.10 En PyTorch
import torchimport torch.nn as nnlayer = nn.TransformerEncoderLayer(d_model=512, nhead=8)
Pourquoi Encoder ?
Historiquement, le transformer est introduit comme une architecture encodeur-décodeur, surtout utile pour la traduction
Aujourd’hui, la plupart des modèles (GPT, LLaMA…) n’utilisent que la partie décodeur
3 Modèles (de Langage) Autoregressifs
3.1 Modèles (de Langage) Autoregressifs avec un transformer
But:
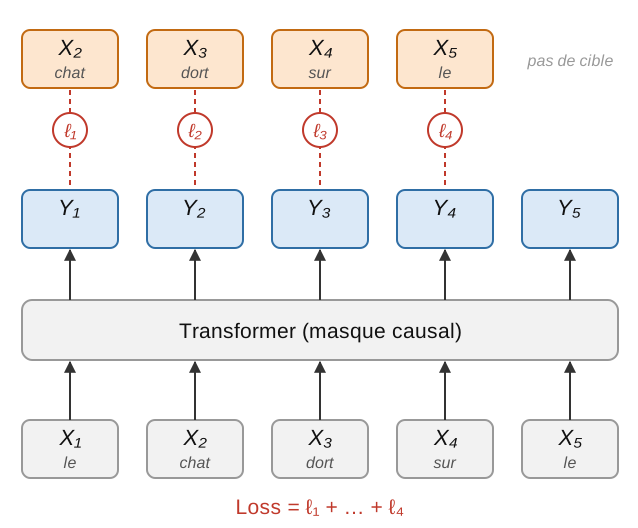
On dispose d’une suite de token \(X_t\) pour \(t = 1...T\)
On veut prédire le token suivant
Transformer:
la séquence \(X\) est transformée en une séquence \(Y\) de même taille
loss : somme des distances entre \(Y_1\) et \(X_2\), …, \(Y_{T-1}\) et \(X_{T}\)
3.2 Causalité
Par défaut:
un token peut faire attention aux tokens qui le suivent
autrement dit: on peut porter attention au futur.
Problème:
au temps \(t\), on a accès à l’information du temps \(t+1\)
il est très facile de prédire \(X_{t+1}\) !
il faut un mécanisme pour empêcher de “voir” le futur
3.3 Masque d’attention
Idée:
On empêche un token de porter attention à un token futur
Pour cela on utilise un masque d’attention
Masque:
matrice \(M\) de taille \(T \times T\)
si \(M_{i,j} = True\), alors le score d’attention avant le softmax est mis à \(-\infty\)
cela entraîne une attention \(A_{i,j} = 0\)
si \(M_{i,j} = False\), cela ne change rien
Remarque: On peut aussi définir le masque comme la valeur qu’il faut ajouter avant le softmax. Cela donne \(M_{i,j} = -\infty\).
3.4 Masque d’attention 2
Masque causal:
Si \(j > i\), alors \(M_{i,j} = TRUE\)
Autrement dit: \(M\) est une matrice triangulaire supérieure
GPT-3 : 300 milliards de tokens. Llama 3 : plus de 15 000 milliards de tokens
Lois d’échelle (Chinchilla, 2022) : à budget de calcul fixé, l’optimal est d’environ 20 tokens par paramètre
Aujourd’hui on entraîne bien au-delà : un modèle plus petit coûte moins cher à utiliser
4.2 Raisonnement
2022 : Chain-of-Thought. Demander au modèle de « raisonner étape par étape » améliore ses réponses
2024-2025 : modèles de raisonnement (o1, DeepSeek-R1). Entraînés à produire un long raisonnement avant de répondre
Le modèle apprend seul à vérifier ses calculs, revenir en arrière, essayer une autre approche
Nouveau levier : le calcul à l’inférence. Plus le modèle réfléchit longtemps, meilleure est la réponse
Exemple : en 2025, des modèles de Google DeepMind et d’OpenAI obtiennent un score de niveau médaille d’or aux Olympiades internationales de mathématiques, sur des problèmes nouveaux.
4.3 Agents
Le LLM peut appeler des outils : exécuter du code, chercher sur le web, lire et écrire des fichiers
Boucle : le modèle choisit une action, on l’exécute, le résultat est ajouté au contexte, etc.
Permet des tâches longues : programmer, faire une recherche bibliographique…
Paul Erdős (1913-1996) a posé des milliers de problèmes, parfois avec une récompense
erdosproblems.com (T. Bloom, 2023) en recense plus de 1 200, dont environ la moitié encore ouverts
Chronologie :
Octobre 2025 : annonce que GPT-5 a « résolu » 10 problèmes ouverts. En fait, il a retrouvé des solutions déjà publiées : une bonne recherche bibliographique, pas une découverte
Fin 2025 - début 2026 : premières vraies résolutions par IA, vérifiées en Lean (par exemple le problème 728). Critique : ce sont des problèmes obscurs, peu étudiés, sans grand intérêt
Mai 2026 : un modèle d’OpenAI réfute une conjecture d’Erdős de 1946 sur les distances unités, avec des configurations de points meilleures que les grilles. Pour T. Gowers, le résultat serait accepté « sans hésitation » dans une grande revue
4.5 Les problèmes du millénaire
2000 : l’institut Clay publie 7 problèmes majeurs, 1 million de dollars chacun (hypothèse de Riemann, P = NP, Navier-Stokes…)
Un seul résolu jusqu’ici : la conjecture de Poincaré (Perelman, 2003)
Navier-Stokes : les équations de la mécanique des fluides. Une solution régulière peut-elle « exploser » (vitesse infinie) en temps fini ?
Septembre 2026 : un système d’environ 10 000 agents d’OpenAI produit, en 88 heures, une preuve d’explosion en temps fini, avec une force extérieure régulière (l’un des énoncés du problème)
preuve vérifiée formellement en Lean
s’appuie sur des travaux humains récents (Córdoba, Martínez-Zoroa, Buckmaster, Alpöge), attribution discutée
le cas sans force reste ouvert
4.6 Perroquet stochastique ?
2021 : “On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?”
« Perroquet stochastique » : les LLM ne comprendraient pas le sens de ce qu’ils produisent, et se contenteraient de recombiner de manière stochastique leurs données d’entraînement
Contrepoint : des représentations internes. Othello-GPT (2023) :
un transformer entraîné uniquement à prédire le coup suivant dans des parties d’Othello
il construit une représentation interne du plateau, qu’on peut lire avec une sonde linéaire
en modifiant cette représentation, on change les coups qu’il prédit
Limite qui demeure : les hallucinations. Un LLM peut affirmer avec assurance des choses fausses.
5 LLM : les transformers modernes
5.1 Le transformer d’un LLM moderne
Transformer (2017)
LLM actuels (Llama, Qwen, DeepSeek…)
Architecture
encodeur-décodeur
décodeur seul, masque causal
Normalisation
Post-LN, LayerNorm
Pre-LN, RMSNorm
Position
sinusoïdale, ajoutée à l’entrée
RoPE : rotation de \(q\) et \(k\) selon la position, dans chaque couche
Attention
multi-head
GQA : plusieurs têtes partagent les mêmes \(K\) et \(V\)
FeedForward
ReLU, dense
SwiGLU, souvent un mélange d’experts
La structure ne change pas : attention + FeedForward + chemin résiduel, répétés \(L\) fois.
5.2 Mélange d’experts (MoE)
Idée : remplacer le FeedForward par \(N\) FeedForward (les experts) et un routeur
Le routeur (une couche linéaire + softmax) donne un score à chaque expert
Pour chaque token, on n’utilise que les \(k\) meilleurs experts (\(k \ll N\)) : la sortie est la somme de leurs sorties, pondérée par les scores
Possible car le FeedForward s’applique token par token