Un réseau feedforward classique traite ses entrées comme un simple vecteur de nombres, sans a priori sur leur organisation. Pour des données tabulaires, c’est un choix raisonnable. Pour une image, c’est ignorer une information précieuse : ses pixels ont une structure spatiale, et les motifs qu’on y cherche — un bord, une texture, une forme — sont locaux. Les réseaux de neurones convolutifs (CNN) exploitent directement cette structure.
1 Pourquoi les CNN ?
Un modèle feedforward classique convient bien à des données tabulaires, sans structure particulière, où l’on n’a pas d’a priori sur les interactions entre variables. Les données perceptuelles — images, sons — posent un défi différent : une image haute résolution représente déjà un très grand nombre de pixels, et une couche entièrement connectée reliant chaque pixel à chaque neurone devient vite coûteuse, à la fois en paramètres et en données nécessaires pour les apprendre.
Or les images ont une structure : elles contiennent des motifs spatiaux exploitables, qui rendent l’apprentissage plus efficace si on sait en tirer parti. C’est exactement ce que font les CNN, en exploitant la structure spatiale des images pour réduire drastiquement le nombre de paramètres nécessaires, grâce à des motifs locaux et des poids partagés.
1.1 Un peu d’histoire
L’idée trouve ses racines dans les années 1980, avec une inspiration explicitement biologique : les travaux de Hubel et Wiesel sur le cortex visuel inspirent le Neocognitron de Fukushima, un des tout premiers réseaux dédiés à la reconnaissance de motifs. Dans les années 1990, Yann LeCun développe LeNet-5, qui exploite déjà convolution et pooling pour la reconnaissance de chiffres écrits à la main, avec un nombre de paramètres maîtrisé — une histoire racontée plus en détail dans l’article sur les origines du deep learning.
Le tournant décisif survient en 2012, avec AlexNet. L’article, publié par Alex Krizhevsky, Ilya Sutskever et Geoffrey Hinton, présente un réseau profond de 8 couches qui remporte le concours ImageNet avec un taux d’erreur bien inférieur à celui de ses concurrents. Cette performance exceptionnelle démontre l’efficacité de l’apprentissage profond pour des tâches complexes, et les CNN prennent alors le pas sur les autres techniques de classification d’images. Depuis, les architectures se sont multipliées — VGG, ResNet, Inception — et les applications ont largement dépassé le cadre des images : vision par ordinateur, traitement du langage, bio-informatique.
2 L’idée : des filtres
Le principe central d’un CNN tient en quelques mots : on construit des filtres, chacun capable d’identifier une structure locale dans l’image — un bord vertical, par exemple. Le filtre est appliqué à toute l’image, et l’apprentissage se charge de trouver les meilleurs filtres pour la tâche à accomplir.
Cette approche présente plusieurs avantages sur une couche entièrement connectée. Un filtre ne comporte qu’un faible nombre de paramètres, puisqu’il ne regarde qu’une petite portion de l’image à la fois. Il est de plus invariant par translation : le même filtre détecte un bord vertical, où qu’il se trouve dans l’image. Enfin, les résultats sont interprétables : on peut afficher les filtres eux-mêmes, ainsi que leur effet sur les images.
En profondeur, cette idée se raffine : on réduit progressivement la dimension de l’image au fil des couches, tandis que les filtres deviennent de moins en moins locaux et apprennent des caractéristiques de plus en plus haut niveau — des bords dans les premières couches, des formes puis des objets entiers dans les couches profondes.
3 La couche de convolution
3.1 Le filtre
Formellement, soit une entrée \(X\) et un noyau \(K\) (le filtre). La valeur en position \((i,j)\) de la sortie \(Y\) est donnée par :
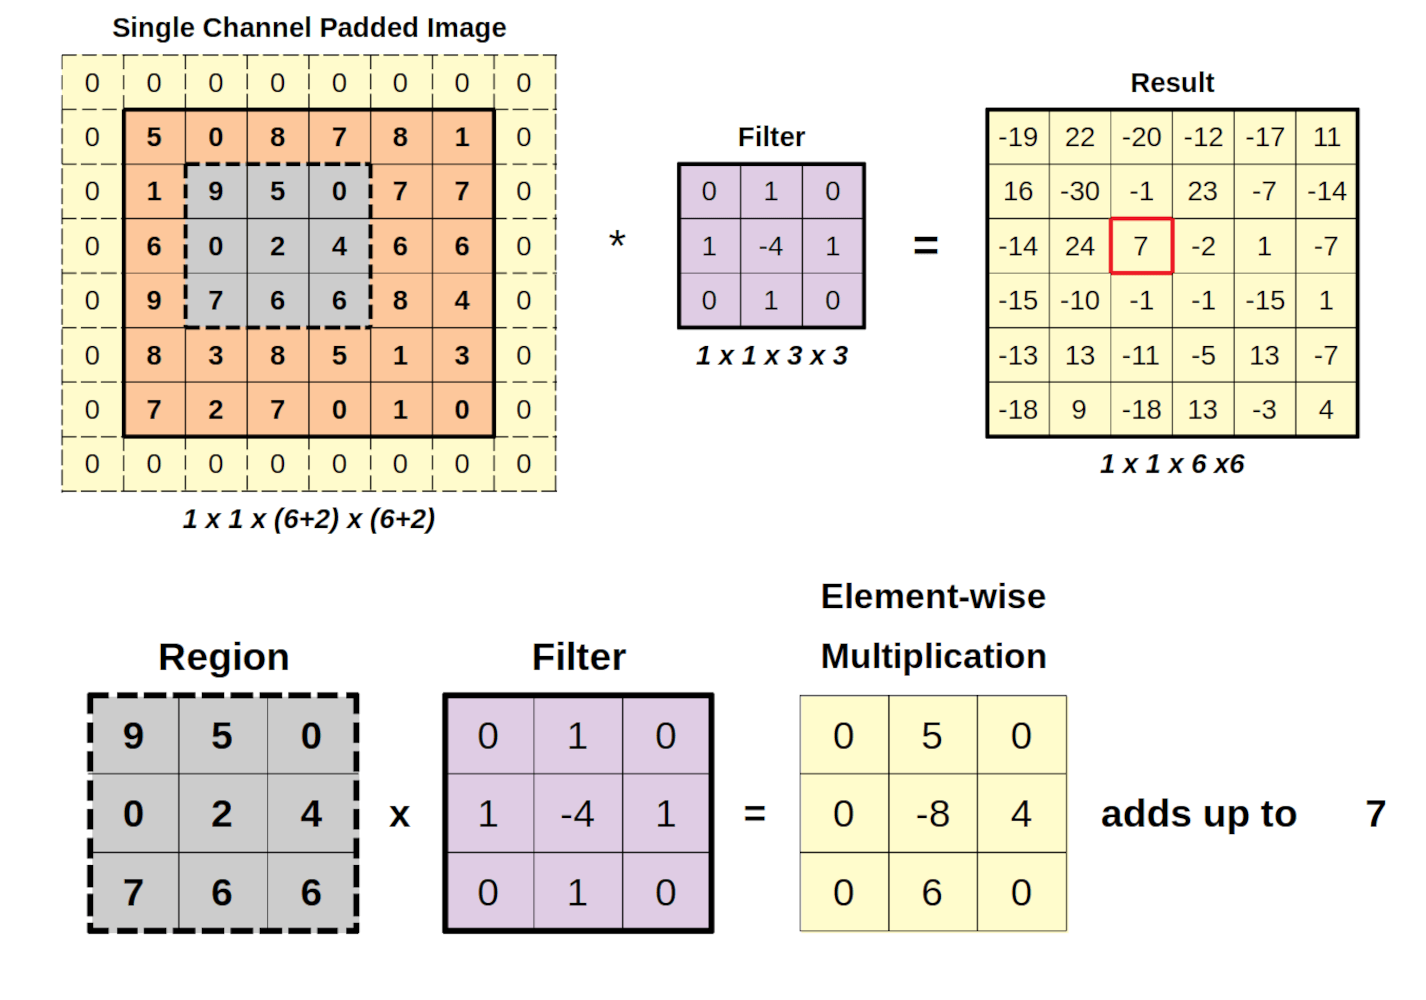
C’est un glissement du noyau : on fait glisser \(K\) sur \(X\), et à chaque position, on effectue une somme pondérée des pixels couverts par le noyau. La sortie d’un filtre est appelée feature map. L’exemple classique du filtre de Prewitt, ci-dessous, illustre concrètement cette opération : appliqué à une image, il en détecte les bords verticaux.
Glissement d’un noyau de convolution sur une image
Afficher le code
import torchimport torch.nn.functional as Fimport torchvision.transforms as transformsfrom torchvision import datasetsimport matplotlib.pyplot as plt# Charger le dataset Fashion MNISTtransform = transforms.Compose([transforms.ToTensor()])train_data = datasets.FashionMNIST(root='./data', train=True, download=True, transform=transform)# Sélectionner une image de l'ensemble de donnéesimage, label = train_data[3] # Image de taille (1, 28, 28)# Filtre de Prewitt (détection des bords verticaux)prewitt_filter = torch.tensor([[1, 0, -1], [1, 0, -1], [1, 0, -1]]).float().unsqueeze(0).unsqueeze(0)# Appliquer la convolution sur l'imageimage = image.unsqueeze(0) # Ajouter la dimension batch (1, 1, 28, 28)output = F.conv2d(image, prewitt_filter, stride=1, padding=0)fig, axs = plt.subplots(1, 3, figsize=(15, 4))axs[0].imshow(prewitt_filter[0][0].detach(), cmap='gray')axs[0].set_title("Matrice du filtre Prewitt")for i inrange(1, 3): axs[0].axhline(i -0.5, color='lightgrey', linewidth=2) axs[0].axvline(i -0.5, color='lightgrey', linewidth=2)axs[0].axis('off')for i inrange(3):for j inrange(3): value = prewitt_filter[0, 0, i, j].item() axs[0].text(j, i, f"{value:.0f}", ha='center', va='center', color='red', fontsize=12, fontweight='bold')axs[1].imshow(image[0][0], cmap='gray')axs[1].set_title(f"Image d'origine\nLabel: {label}")axs[1].axis('off')axs[2].imshow(output[0][0].detach(), cmap='gray')axs[2].set_title("Après convolution avec Prewitt")axs[2].axis('off')plt.tight_layout()plt.show()
3.2 Padding, stride, dilatation
Trois réglages complètent la définition d’une couche de convolution.
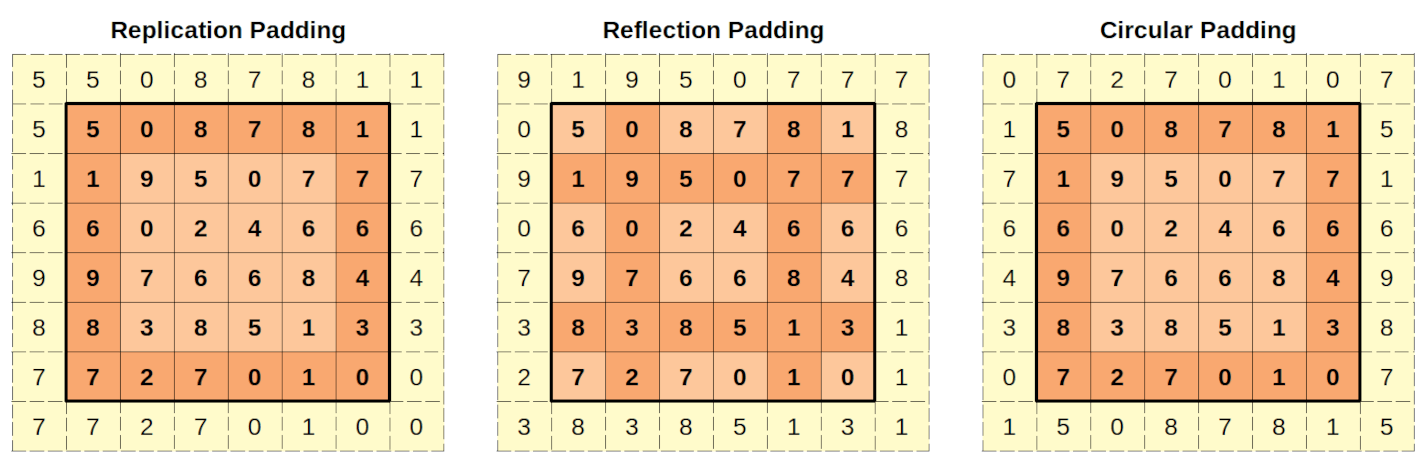
Par défaut, une convolution réduit la taille de l’image en sortie : le noyau ne peut se centrer que sur les positions où il tient entièrement dans l’image. Le padding ajoute des bordures de pixels autour de l’image pour préserver ses dimensions d’origine et conserver l’information aux bords — que ce soit par des zéros (zero padding), par réplication des pixels du bord, ou par réflexion.
Le padding préserve les dimensions de l’image en sortie
Le stride est le nombre de pixels dont le noyau se déplace à chaque étape (1 par défaut). Plus il est grand, plus la sortie est petite : le stride contrôle directement la réduction de taille de la sortie.
La dilatation espace les éléments du noyau en insérant des « trous » entre eux, sans augmenter le nombre de paramètres du filtre. Une dilatation de facteur \(d\) laisse \(d-1\) pixels vides entre les éléments du noyau : un noyau \(3\times3\) avec \(d=2\) couvre ainsi un espace de \(5\times5\) pixels, ce qui permet de capturer des motifs à plus grande échelle sans perdre en résolution.
En combinant ces trois paramètres, la dimension de sortie \(n_{\text{out}}\) d’une convolution s’écrit :
où \(n\) est la taille de l’entrée, \(k\) celle du noyau, \(p\) le padding, \(s\) le stride et \(d\) la dilatation.
Afficher le code
import torchimport torch.nn as nnclass SimpleConvLayer(nn.Module):def__init__(self):super(SimpleConvLayer, self).__init__()self.conv = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, stride=1, padding=1)self.relu = nn.ReLU()def forward(self, x): x =self.conv(x) # Convolution x =self.relu(x) # Fonction d'activationreturn x
3.3 Plusieurs canaux
Une image n’a en général pas un seul canal : une image RGB, par exemple, en a trois (rouge, vert, bleu). Pour une entrée de taille \((H \times W \times C_{in})\), chaque filtre est alors de taille \((k \times k \times C_{in})\) — il s’applique simultanément à tous les canaux d’entrée — et produit un seul canal en sortie, en combinant l’information des \(C_{in}\) canaux.
Une couche convolutive peut comporter plusieurs filtres à la fois : sa sortie a alors \(C_{out}\) canaux, un par filtre, de taille \((H_{\text{out}} \times W_{\text{out}} \times C_{out})\). Autrement dit, une couche de convolution est entièrement définie par une matrice de poids — qui contient les matrices de tous ses filtres — et un vecteur de biais, avec un biais par filtre.
4 Le pooling
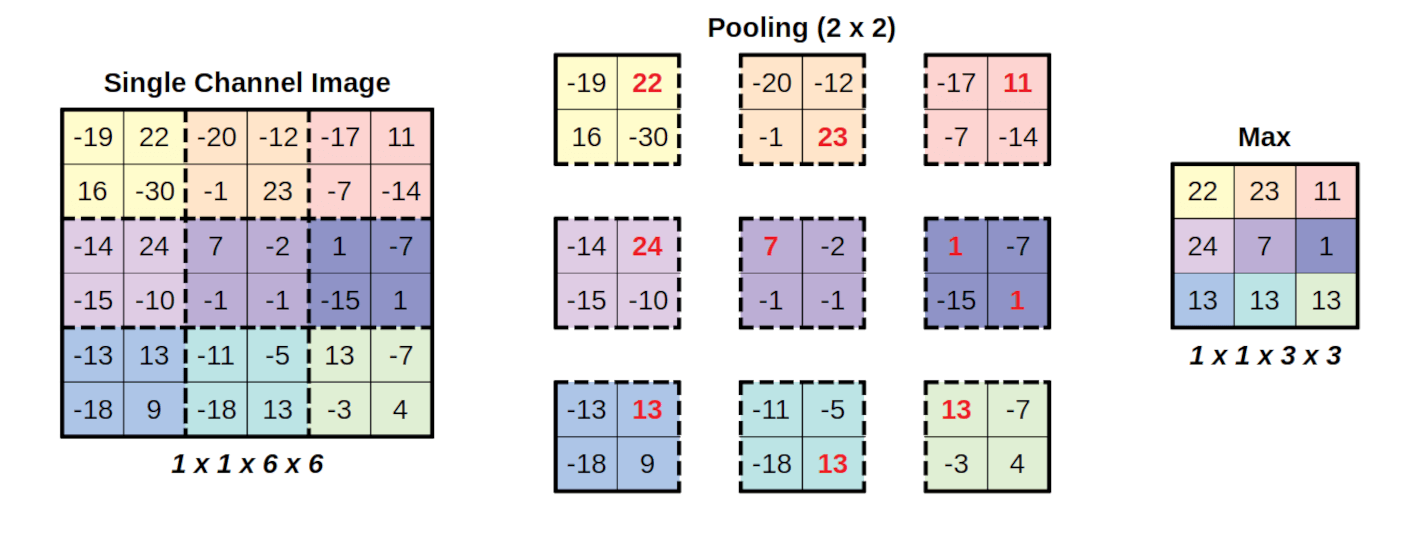
Le pooling réduit la taille des feature maps tout en conservant l’information importante, dans le but de diminuer la complexité computationnelle et de limiter le surapprentissage. Les deux variantes les plus courantes sont le max pooling, qui sélectionne la valeur maximale dans chaque fenêtre, et l’average pooling, qui en calcule la moyenne.
Max pooling, stride 2, fenêtre 2×2
4.1 Un CNN complet en PyTorch
En combinant convolutions, activations et pooling, on obtient un CNN complet. Voici un exemple simple, conçu pour des images 28×28 (comme celles de FashionMNIST) : deux couches de convolution, chacune suivie d’une activation ReLU et d’un pooling qui divise la résolution par deux, puis une couche entièrement connectée pour la classification finale.
Afficher le code
import torch.nn as nnimport torch.nn.functional as Fclass SimpleCNN(nn.Module):def__init__(self):super(SimpleCNN, self).__init__()# Première couche de convolution (entrée : 1 canal, sortie : 32 filtres)self.conv1 = nn.Conv2d(1, 32, kernel_size=3, padding=1)# Deuxième couche de convolution (entrée : 32 canaux, sortie : 64 filtres)self.conv2 = nn.Conv2d(32, 64, kernel_size=3, padding=1)# Couche de poolingself.pool = nn.MaxPool2d(2, 2)# Couche entièrement connectéeself.fc1 = nn.Linear(64*7*7, 10) # Image de 28x28, réduite à 7x7 après 2 poolingsdef forward(self, x):# Première convolution + ReLU + Pooling x =self.pool(F.relu(self.conv1(x)))# Deuxième convolution + ReLU + Pooling x =self.pool(F.relu(self.conv2(x)))# Aplatir pour la couche entièrement connectée x = x.view(-1, 64*7*7)# Couche entièrement connectée x =self.fc1(x)return x
5 Le champ réceptif
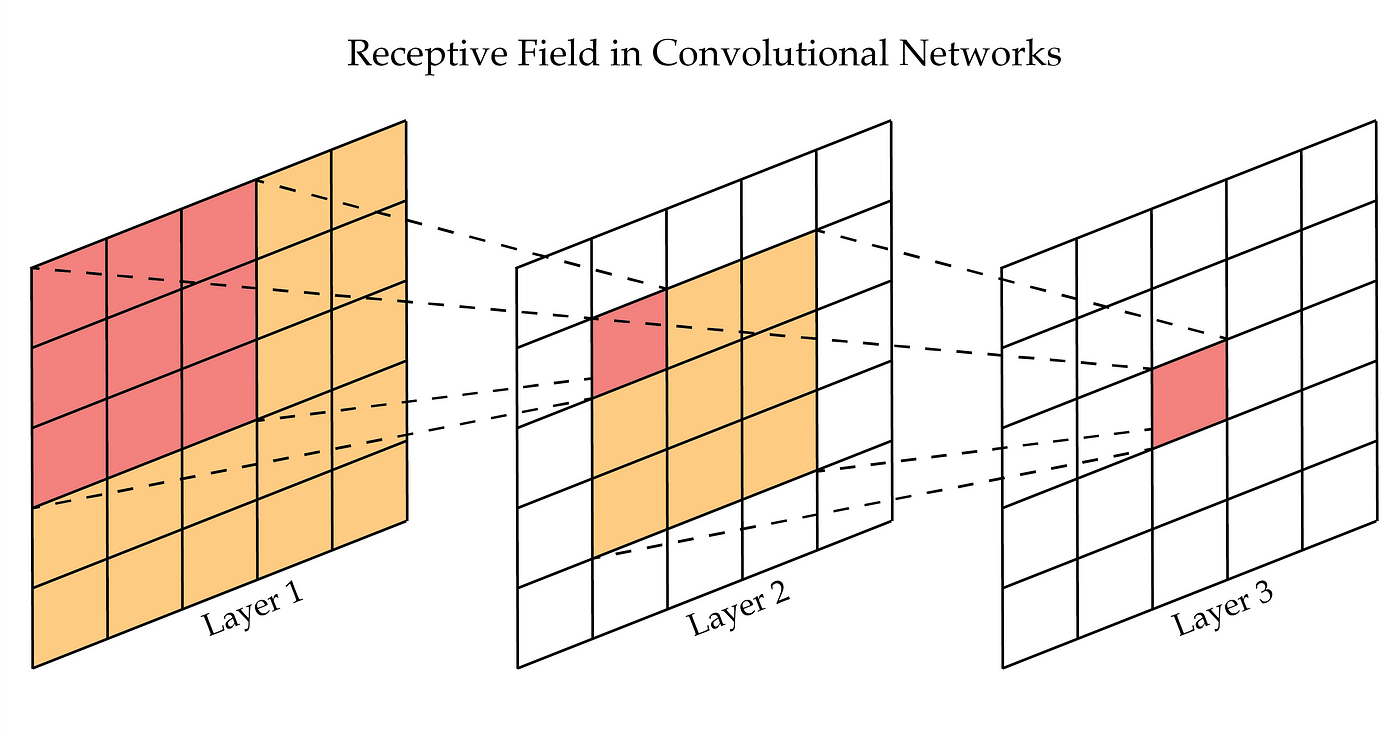
Une dernière notion complète ce panorama : le champ réceptif d’une activation est la zone de l’image d’entrée qui l’influence. Dans un CNN à plusieurs couches, ce champ grandit avec la profondeur : même avec un filtre \(3\times3\) à chaque couche, le champ réceptif d’un pixel en couche profonde finit par couvrir une large portion de l’image d’origine.
Le champ réceptif grandit avec la profondeur
Cette croissance progressive n’est pas un détail technique : elle traduit une hiérarchie de l’information bien réelle. Les premières couches captent des détails locaux — bords, textures — tandis que les couches profondes, avec leur champ réceptif étendu, captent la structure globale de l’image. C’est cette hiérarchie qui rend un large champ réceptif si utile en pratique : essentiel pour détecter des objets de grande taille, ou pour segmenter une image en capturant les contours complets des objets qui la composent.
Un dernier point, pratique plutôt que théorique, mérite d’être signalé : entraîner un CNN sur des images se prête particulièrement bien au calcul sur GPU. En PyTorch, tout calcul s’exécute sur un device, par défaut le CPU ; s’il est disponible, on peut lui préférer un GPU, via CUDA pour les cartes graphiques NVIDIA.
Afficher le code
device = torch.device("cuda"if torch.cuda.is_available() else"cpu")print(f"Utilisation du device : {device}")
Utilisation du device : cuda
Le résultat dépend de l’environnement d’exécution : cuda si un GPU est disponible, cpu sinon.
Chaque device dispose de sa propre mémoire. Par défaut, un tensor est créé sur le CPU ; il faut explicitement le déplacer vers le device souhaité pour y effectuer des calculs, avec .to(device). On peut à tout moment consulter le device sur lequel se trouve un tensor donné.
Afficher le code
x = torch.tensor([1.,2.])y = x.to(device)print(y.device)
cuda:0
On peut de la même façon envoyer un modèle complet, avec tous ses paramètres, sur un device donné, via model.to(device) : les calculs s’effectuent alors sur le device des tensors qu’on lui passe. Un point de vigilance à retenir : on ne peut pas mélanger, dans un même calcul, des tensors situés sur des devices différents — un modèle sur GPU doit recevoir des données elles aussi déplacées sur GPU.
_files/figure-html/cell-2-output-1.png)